Deep Seek · LAYER 01 OFFICIAL VERSE SHEET · Deep Seek
「于无路处拓荒推理星图,在算力深井中凝视未至之境。」—— DeepSeek 官网诗句叠片 · 上层
Deep Seek // MARGIN_MARK_01
DeepSeek
SLIDE_DECK: 01/03 [UPPER_VERSE]
MARGIN: Deep Seek
TELEMETRY: ONLINE
ALT: 14,800M // NADIR_VIEW
MODEL: R1-671B-MOE / V3
STATUS // 200_OK · 叠片透光缝已校准
DeepSeek是专注通用人工智能底层突破的认知引擎,以纯粹强化学习与稀疏架构探索未至之境。
在 DeepSeek官网上层诗句叠片、中层 DeepSeek网页版与下层 API 加 Harness 三层全屏胶片之间自由抽拉,彻底解决超长上下文推理延迟与复杂工程代码合成难题。内置多头潜在注意力(MLA)与无辅助损失负载均衡专家混合架构,支持 DeepSeek R1满血版在线使用与 DeepSeek V3代码生成。
STAGE_01 // REALTIME WORKBENCH
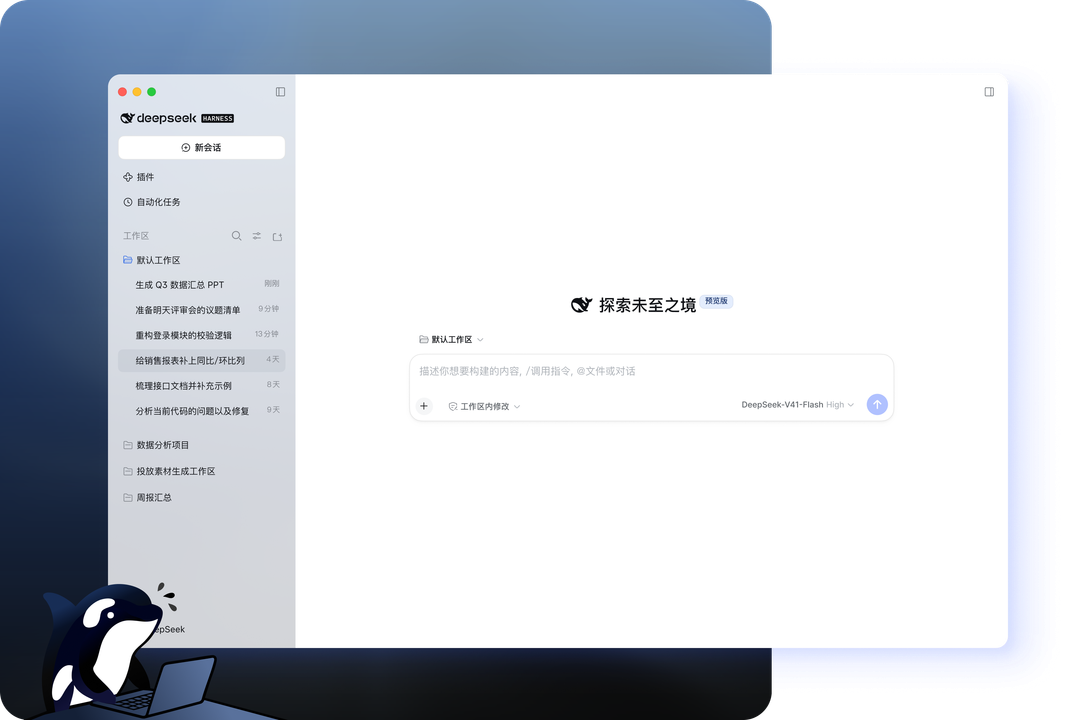
三层叠片直连台 · DeepSeek网页版真实推理界面
拉开展台即可直视思维链(CoT)逐词展开过程,无缝衔接 DeepSeek R1满血版在线使用与本地工程仓库诊断。
deepseek-workbench://slide-deck-01/r1-reasoning-session
● STREAMING_TPS: 84.6 TOK/S · Deep Seek
Deep Seek · SHEET_A
01 // ARCHITECTURE BREAKTHROUGH
MLA 多头潜在注意力与 DeepSeekMoE 架构突破
通过低秩键值联合压缩技术大幅削减推理显存占用,配合 FP8 混合精度训练与跨节点通信重叠,使 DeepSeek V3代码生成与长文本逻辑推演兼具低成本与高吞吐。
@@ -42,6 +42,8 @@ class DeepSeekAttentionLayer(nn.Module):
- kv_cache = torch.cat([past_k, past_v], dim=-1) # 标准全量KV显存瓶颈
- attn_out = dense_sdp_attention(q, kv_cache, mask)
+ c_kv = self.kv_down_proj(hidden_states) # MLA低秩潜在向量压缩 (减少78% KV缓存)
+ k_rope, v_latent = self.kv_up_proj(c_kv, rope_pos)
+ attn_out = flash_mla_kernel(q, k_rope, v_latent, fp8_scale=True)
Deep Seek · SHEET_B
02 // MULTI-SCENARIO CAPABILITY
全栈代码合成、奥数级数理证明与多模态文档解析
无论是在 DeepSeek网页版执行跨语言微服务重构,还是参照 DeepSeek本地部署教程构建企业私有知识库,均可通过叠片透光缝入口获得高确定性的结构化输出。
Deep Seek · SHEET_FULL
03 // OBSERVABILITY & HARNESS AUTOMATION
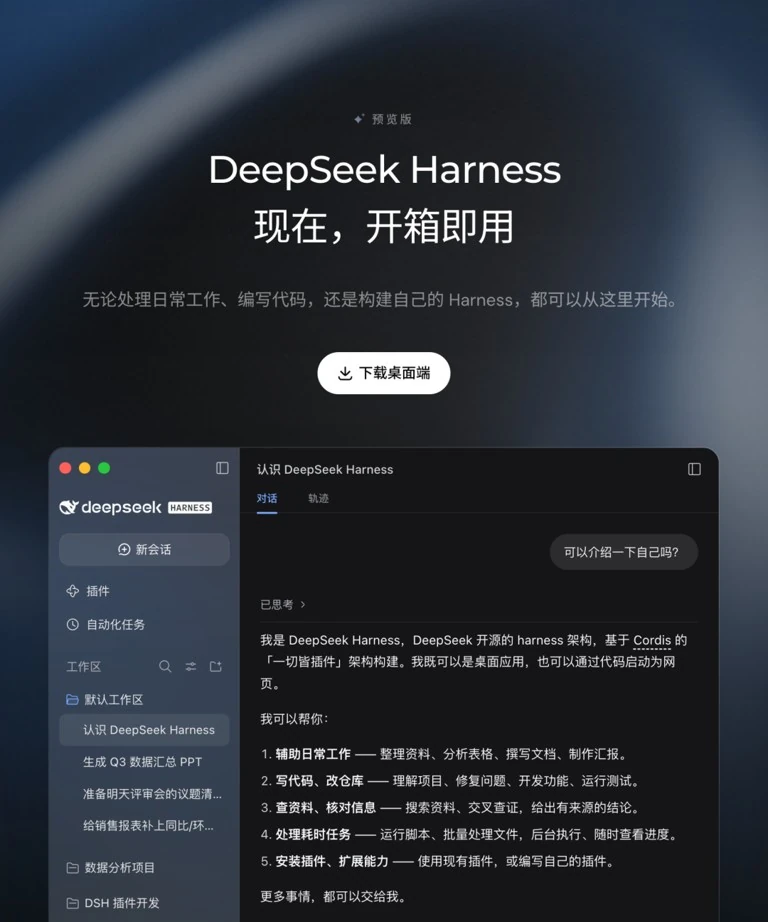
全链路思维轨迹可观测性与 DeepSeek Harness 自动化评测
下层叠片原生集成 DeepSeek Harness 评测套件,实时捕获每一轮强化学习反思节点、工具调用耗时与沙箱回归覆盖率,确保生产级 Agent 轨迹透明可控。
{
"slide_layer": "03_API_HARNESS",
"trace_id": "ds-r1-99402a",
"verify_gate": "PASSED",
"reasoning_tokens": 1420,
"sandbox_exec_ms": 184
}
curl -sS https://api.deepseek.com/v1/chat/completions -H "Authorization: Bearer $DEEPSEEK_API_KEY" -d '{"model":"deepseek-reasoner","messages":[{"role":"user","content":"探索未至之境"}]}'